即时通讯云IM(Instant Messaging Cloud)作为支撑海量用户实时交流的基础设施,不仅需要高效的消息传输能力,还依赖强大的数据存储与数据处理服务来保障消息的持久化、检索、同步以及丰富的扩展功能。本文将详细梳理即时通讯云IM所支持的数据存储服务类型和数据处理服务类型,帮助开发者与技术选型者建立全面的认知。
一、数据存储服务类型
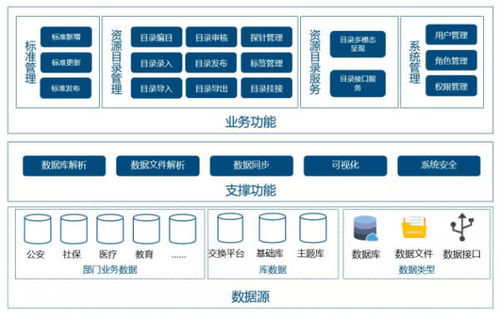
即时通讯云IM通常采用多种存储系统组合,以满足不同数据特征和访问模式的需求。主要支持以下几类:
- 关系型数据库
- 代表:MySQL、PostgreSQL
- 用途:存储用户账号、好友关系、群组元数据、消息索引等结构化数据。支持事务,保证数据一致性。
- 特点:强一致性、支持复杂查询,但扩展性相对有限,通常通过分库分表应对海量数据。
- NoSQL数据库
- 键值存储:如Redis、Memcached,用于缓存会话信息、在线状态、最近联系人列表等,提供亚毫秒级读写。
- 文档数据库:如MongoDB,适合存储半结构化的消息内容、用户配置,模式灵活。
- 宽列存储:如HBase、Cassandra,常用于存储海量历史消息,支持高写入吞吐和水平扩展。
- 时序数据库
- 代表:InfluxDB、TimescaleDB
- 用途:存储消息发送/接收的时序指标(如延迟、吞吐量)、用户活跃度时间线,用于监控和统计分析。
- 对象存储
- 代表:AWS S3、阿里云OSS、腾讯云COS
- 用途:存储富媒体文件(图片、音频、视频、文件),通过CDN加速访问。通常与消息体分离,消息中仅保存文件URL。
- 图数据库
- 代表:Neo4j、JanusGraph
- 用途:存储社交关系网络(好友关系、群组成员关系),高效支持多度关系查询、共同好友推荐等。
- 搜索引擎
- 代表:Elasticsearch、Solr
- 用途:存储消息全文索引,支持关键词搜索、聊天记录检索、过滤和聚合分析。
- 分布式文件系统
- 代表:HDFS、Ceph
- 用途:在大数据场景下存储原始日志、备份数据,供离线分析使用。
二、数据处理服务类型
数据处理服务负责对存储的数据进行实时或批量的计算、转换、分析和推送,是IM云功能丰富性的关键。主要包含:
- 消息队列与流处理
- 代表:Kafka、Pulsar、RocketMQ
- 用途:解耦消息生产与消费,缓冲高峰流量,实现异步处理。支持消息有序、至少一次/精确一次语义。
- 流处理引擎:Flink、Spark Streaming、Storm,用于实时计算消息统计、敏感词过滤、实时推送等。
- 实时计算服务
- 用途:在线统计(如日活、消息量)、实时监控告警、动态扩容决策。
- 技术:Flink、Kafka Streams,结合CEP(复杂事件处理)识别异常模式。
- 离线批处理服务
- 代表:Hadoop MapReduce、Spark、Hive
- 用途:对历史消息、用户行为进行批量分析,生成报表、用户画像、推荐模型。
- 数据同步服务
- 用途:多数据中心之间数据同步、多云灾备、就近接入。
- 技术:CDC(变更数据捕获)、DTS(数据传输服务)、rsync等,保证最终一致性。
- 函数计算与Serverless
- 代表:AWS Lambda、阿里云函数计算
- 用途:事件驱动的轻量处理,如消息发送后触发回调、图片压缩、内容审核,无需管理服务器。
- AI与机器学习服务
- 用途:智能内容审核(文本/图片/视频)、反垃圾、智能推荐、聊天机器人、语音识别与合成。
- 技术:TensorFlow、PyTorch模型部署,结合GPU加速。
- 数据可视化与BI
- 代表:Tableau、Superset、Grafana
- 用途:将处理后的数据以图表形式展现,辅助运营决策、监控系统健康度。
- 推送与通知服务
- 用途:处理离线消息推送、系统通知,集成APNs、FCM、厂商推送通道。
- 技术:推送网关、消息路由,确保高送达率。
三、
即时通讯云IM的数据存储与处理服务是一个多层次、多技术栈融合的体系。存储方面,关系型数据库、NoSQL、时序、对象、图、搜索等各司其职;处理方面,消息队列、流计算、批处理、AI、同步等协同工作。开发者应根据业务规模、性能要求和成本预算,合理选择和组合这些服务,以构建高可用、可扩展的IM系统。随着云原生和AI技术的发展,Serverless与智能化处理正成为IM云服务的重要演进方向。